Aplicando conceitos de Deep Learning para criar uma rede neural recorrente capaz de prever o preço do Bitcoin baseado em seu histórico

Motivação
A falta de material prático e gratuito sobre o assunto em português!
Existem diversos artigos escritos em inglês sobre como tentar prever o preço de uma criptomoeda (ou ação), utilizando 1 ou mais indicadores, através de algum tipo de Rede Neural Recorrente(RNN), mas poucos falando sobre o tema em português, e nenhum(grátis, que eu tenha lido) explicando o passo a passo do que deve ser feito para aplicá-lo na prática.
Objetivo
Demonstrar como é possível montar, treinar e testar uma rede LSTM(Long Short-Term Memory), apresentando todos os obstáculos a serem vencidos no meio do caminho, a fim de obter uma predição do preço do bitcoin baseada em preços e indicadores passados.
NÃO pretendo me aprofundar sobre o funcionamento de RNNs e LSTMs, tampouco sobre como extrair os dados consumindo API's ou através de crawlers, o foco do artigo é colocar a mão na massa: montar, treinar e testar.
Para melhor entendimento, adicionei diversos links ao decorrer do texto que possuem explicações detalhadas dos assuntos que não abordei, sugiro que os leia sempre que tiver dúvida.
A linguagem escolhida é o Python 3.7 e as bibliotecas utilizadas são: Pandas, NumPy, Keras, SKLearn, Joblib e MatPlotLib. É possível instalá-las através do comando pip install (caso tenha dúvida, leia o readme do repositório no github)
Aquisição dos dados
Primeiramente, é preciso ter um bom conjunto de dados, diria que no mínimo 9.000 linhas para treinar seu modelo e 1.000 linhas para testá-lo(note que esses valores são relativamente pequenos quando o assunto é treinamento de Redes Neurais, mas já é um começo).
Disponibilizei dois arquivos "btcusdt_treino.csv" e "btcusdt_teste.csv", onde cada linha representa uma vela de transação de 1 minuto do par BTC_USDT da binance, com as seguintes informações: Data(de Abertura), Preço, MA7, MA25, e Número de Transações.
- MA7 = Média Móvel do preço baseada em 7 velas passadas
- MA25 = Média Móvel do preço baseada em 25 velas passadas
Você pode conseguir estes dados consumindo a API da Binance gratuitamente, mas a massa de dados que utilizarei, pode baixar aqui.
Preparação dos dados
O primeiro passo é criar a seguinte estrutura de arquivos:
- dados/
  btc_usdt_treina.csv
  btc_usdt_testa.csv
main.py
prepara.py
treina.py
testa.py
A ideia é que cada arquivo contenha apenas métodos essenciais para atingir seu objetivo.
Começarei com o prepara.py. A princípio construirei uma função que carrega os dados do disco para a memória, ordena-os por data e remove a coluna de data(pois não será utilizada como parâmetro de entrada, uma vez que os dados estão ordenados).
#prepara.py
import pandas as pd

def carrega(caminho):
    dados = pd.read_csv(caminho)
    dados = dados.sort_values(by=['Data'])
    del dados['Data']
    return dados
Depois de carregados, prepararei os dados para usá-los como entrada da rede neural.
Normalização dos dados
Para diminuir o tempo de treinamento e maximizar a assertividade, deve-se normalizar os parâmetros de entrada da rede neural. Essa etapa pode ser um pouco problemática caso você não entenda o que está fazendo, portanto, explicarei um pouco do conceito.
Normalizar dados serve para diminuir a variação de valores de um determinado conjunto, colocando-os em um intervalo pré definido, geralmente de (-1 a 1) ou de (0 a 1). Essa prática auxilia a rede a convergir(achar os pesos corretos) mais rapidamente.
Uma forma de normalizar seu conjunto é pegar o valor máximo e definir como 1, o valor mínimo como 0(ou -1) e utilizar uma função para definir o restante dos valores:
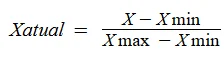
É possível abstrair esse cálculo através da função MinMaxScaler do SKLearn!
A função MinMaxScaler recebe como parâmetro o feature_range, que é o intervalo em que os dados ficarão depois de normalizados, e também a matriz a ser normalizada.
Com o método fit_transform, além de realizar a transformação dos dados, o SKLearn salva as dimensões do vetor de entrada no normalizador, e não aceitará nenhum outro formato de vetor futuramente.
Isso é muito importante e foi razão de algumas dores de cabeça que tive ao aprender sobre o assunto.
Ao normalizar os dados de entrada, a dimensão é salva no normalizador, porém, o formato dos valores de saída(previsão) da rede é de X:1(X linhas, 1 coluna), logo, não será possível utilizar o mesmo normalizador para reverter os valores diretamente, esse é o primeiro obstáculo da normalização.
Para resolver isto, existem algumas opções:
- Utilizar um normalizador extra apenas para a coluna de preço e reverter as previsões futuramente
- Transformar a matriz de previsão (X:1) para que possua as mesmas dimensões que a matriz de entrada (X:4) e reaproveitar o normalizador
Tendo em mente que na maioria das vezes os dados de teste possuem variação menor do que os dados de treino, e que também serão normalizados, apresento o segundo obstáculo: Deve-se utilizar mais de um normalizador? Se sim, qual será utilizado para reverter os dados? O de teste ou de treino?
A minha resposta é não! Utilizar um normalizador diferente para o conjunto de teste acarretará numa função diferente de normalização, visto que os valores de máximo e mínimo provavelmente não são os mesmos que foram utilizados no treinamento da rede. Isso pode melhorar a aproximação entre o valor previsto e o valor real, mas é uma falsa melhoria, pois a rede foi treinada e normalizada baseada na função normalizadora dos dados de treino, não de teste!
Descobri isso após diversas tentativas diferentes de normalizar e desnormalizar os valores, apanhei bastante dos dados e até me iludi com falsos resultados, e por esses motivos, escolherei a opção 2: um único normalizador para todos os casos vai evitar dor de cabeça!
Abaixo, a função normaliza serve para criar ou carregar o normalizador e normalizar os dados.
#prepara.py
import os
from sklearn.preprocessing import MinMaxScaler

def normaliza(dados):
    caminho = 'normalizador.joblib.pkl'
    if not os.path.isfile(caminho):
       #caso ainda não exista
       #inicializa-o com a função MinMaxScaler
       normalizador = MinMaxScaler(feature_range=(0,1))
       #utiliza a função fit_transform para moldar o normalizador
       dados_normalizados = normalizador.fit_transform(dados)
       joblib.dump(normalizador, caminho)
    else:
       #se já existe, carrega-o em memória e transforma
       #os dados com apenas transform
       normalizador = joblib.load(caminho)
       dados_normalizados = normalizador.transform(dados)

    return dados_normalizados
Agora, criarei uma função "prepara" que receberá três parâmetros: o vetor de dados, o nome da coluna target(que pretende-se prever) e o histórico(minutos passados) que serão levados em consideração.
O objetivo desta função é: normalizar os dados de entrada, separar os dados esperados, montar um vetor de entrada com todos os dados dos minutos passados(baseado no parâmetro histórico) e retornar os dados de treino e dados esperados. O histórico representa a quantidade de minutos passados que serão levados em consideração para cada palpite.
#prepara.py
from sklearn.preprocessing import MinMaxScaler
import joblib
import numpy as np

def prepara(dados, coluna_esperada, historico):
    entrada_normalizada = normaliza(dados)
    #guarda os dados esperados em memória
    pos_esperado = dados.columns.get_loc(coluna_esperada)
    dados_esperados = entrada_normalizada[:, pos_esperado: pos_esperado+1]
    #ignora os primeiros dados(que não possuem historico)
    dados_esperados = dados_esperados[historico:, :]
No trecho abaixo, montarei o vetor de entrada da rede utilizando um laço de repetição no qual, junto a cada linha, agruparei os dados dos últimos 60 minutos (histórico) antes de retornar os dados de treino e os dados esperados, ou seja, ao prever o valor de 1 minuto a rede se baseará nos valores, médias e números de transações da última hora.
    dados_treino = []
    for i in range(historico, len(entrada_normalizada)):
        dados_treino.append(entrada_normalizada[i - historico:i, :])

    #transforma todos em arrays com numpy
    dados_treino = np.array(dados_treino)
    dados_esperados = np.array(dados_esperados)

    return [dados_treino, dados_esperados]
Criação do Modelo
Utilizarei o framework keras para montar a rede. Como dito anteriormente, não abordarei a parte teórica de seu funcionamento, me limitarei a explicar um pouco sobre os hiperparâmetros necessários para seu funcionamento.
O método mais disseminado para escolha de hiperparâmetros é, acredite, tentativa e erro(força bruta), que consiste em alterar o número de camadas LSTM, funções de otimização, tamanho de lote e épocas até encontrar uma configuração que atinja o maior percentual de assertividade.
Neste artigo proponho uma arquitetura escolhida após alguns testes de desempenho, mas pode ser que existam configurações alternativas que melhorem o resultado.
Configurar hiperparâmetros de maneira Eurística não é algo que me agrada. Apesar de alguns artigos citarem abordagens de Computação Evolutiva, Algoritmos de Códigos Genéticos ou Algoritmo do Gradiente Descendente Estocástico para maximizar o a eficácia na escolha de hiperparâmetros da rede, ainda não me aprofundei o suficiente nesses temas para aplicá-los, portanto, apenas recomendo a leitura.
Primeiro, importarei algumas funções: Sequential para inicializar a rede neural, Dropout para evitar sobreajuste (overfitting), LSTM para as camadas e Dense para centralizar as saídas das camadas LSTM.
#treina.py
from keras.models import Sequential
from keras.layers import Dropout, LSTM, Dense
Hiperparâmetros
- Return_sequences = true: para poder "empilhar" as camadas de LSTM, fazendo com que a camada seguinte seja alimentada pela anterior.
- Input_shape: são as dimensões dos dados a serem treinados(no caso, (dias_atras, parametros)).
- Dropout 0.3: Significa que 30% dos neurônios serão ignorados, isso ajuda a evitar o overfitting.
- Dense 1: Indica que a rede possuirá apenas 1 saída.
- Otimizador: Utilizarei o otimizador adam.
- Loss: Utilizarei a função mean_squared_error.
#treina.py
def cria_modelo(historico, parametros):
  modelo = Sequential()
  modelo.add(LSTM(units=100, return_sequences=True,
       input_shape=(historico, parametros)))
  modelo.add(Dropout(0.3))
  modelo.add(LSTM(units=50, return_sequences=True))
  modelo.add(Dropout(0.3))

  modelo.add(LSTM(units=50))
  modelo.add(Dropout(0.3))
  modelo.add(Dense(units=1))
  modelo.compile(optimizer='adam', loss='mean_squared_error')
  return modelo
Callbacks
Callbacks são ferramentas do keras que existem para auxiliar o processo de treinamento da rede neural, utilizarei alguns deles visando maximizar o desempenho e reduzir o tempo de treinamento:
- EarlyStopping: Interrompe o treinamento caso perceba que a função de loss não diminui depois de determinadas épocas.
- ReduceLROnPlateau: Reduz o LR(LearningRate) visando melhor aprendizagem ao longo das épocas, uma boa explicação teórica pode ser encontrada aqui.
- ModelCheckpoint: Salva os melhores pesos da rede em disco, para reaproveitá-los futuramente(visto que o processo de treinamento geralmente é demorado).
A função treina recebe como parâmetro: o modelo, dados de treino, dados esperados e por quantas épocas ele será treinado.
#treina.py
from keras.callbacks import EarlyStopping, ReduceLROnPlateau, ModelCheckpoint

def treina(modelo, dados_treino, dados_esperados, epochs=100):
    es = EarlyStopping(monitor='loss', min_delta=1e-10,
          patience=10, verbose=1)
    rlr = ReduceLROnPlateau(monitor='loss', factor=0.2,
          patience=5, verbose=1)
    mcp = ModelCheckpoint(filepath = 'pesos.h5', monitor='loss',
          save_best_only = True, verbose=1)
    #treina o modelo
    modelo.fit(dados_treino, dados_esperados, batch_size=32,
             callbacks=[es, rlr, mcp], epochs=epochs)
    return modelo
Treino
Agora com a função de treinamento criada, treinarei o modelo com os dados de entrada no arquivo main.py
#main.py
from prepara import carrega, prepara
from treina import cria_modelo, treina

caminho = 'dados/btcusdt_treino.csv'
historico = 60
dados = carrega(caminho)
dados_treino, dados_esperados = prepara(dados, 'Preço', historico)
modelo = cria_modelo(historico, dados_treino.shape[2])
modelo = treina(modelo, dados_treino, dados_esperados)
Testando o modelo
Depois de finalizado o treinamento do modelo, é hora de validá-lo e para isso, criarei uma função no arquivo testa.py
A função testa pode receber o modelo de duas formas: em memória ou o caminho para carregar os pesos(configurado no callback ModelCheckpoint). Caso receba o caminho, recria o modelo e carrega seus pesos, daí, através da função prepara do arquivo prepara.py, carrega os dados de teste para memória e formata-os com a mesma função utilizada durante o treinamento.
Note que: ao chamar a função prepara, utilizo o mesmo normalizador que foi salvo durante o treinamento, via função normaliza(o que ocorre desta vez é que o arquivo normalizador.joblib.pkl já está em disco e é reutilizado).
A função predict retorna uma listagem com os valores previstos pela rede neural, através dos dados de teste inseridos como entrada.
#testa.py
from prepara import carrega, prepara
from treina import cria_modelo
import matplotlib.pyplot as plt

def testa(modelo, caminho, hist, parametros):
    if isinstance(modelo, str):
        temp = cria_modelo(hist, parametros)
        temp.load_weights(modelo)
        modelo = temp
    dados = carrega(caminho)
    dados_teste, dados_esperados = prepara(dados, 'Preço', hist)
    previstos = modelo.predict(dados_teste)

    plt.plot(dados_esperados, color='blue', label='Preço real')
    plt.plot(previstos, color='red', label='Preço previsto')
    plt.title('Previsão do preço do bitcoin')
    plt.xlabel('Tempo')
    plt.ylabel('Preço')
    plt.legend()
    plt.show()
Agora, ao rodar este pedaço de código abaixo na função main.py, surge o primeiro resultado gráfico:
#main.py
from prepara import carrega, prepara
from treina import cria_modelo, treina
from testa import testa

caminho = 'dados/btcusdt_treino.csv'
historico = 60
dados = carrega(caminho)
dados_treino, dados_esperados = prepara(dados, 'Preço', historico)
modelo = 'pesos.h5'
testa(modelo, 'dados/btcusdt_teste.csv', historico, dados_treino.shape[2])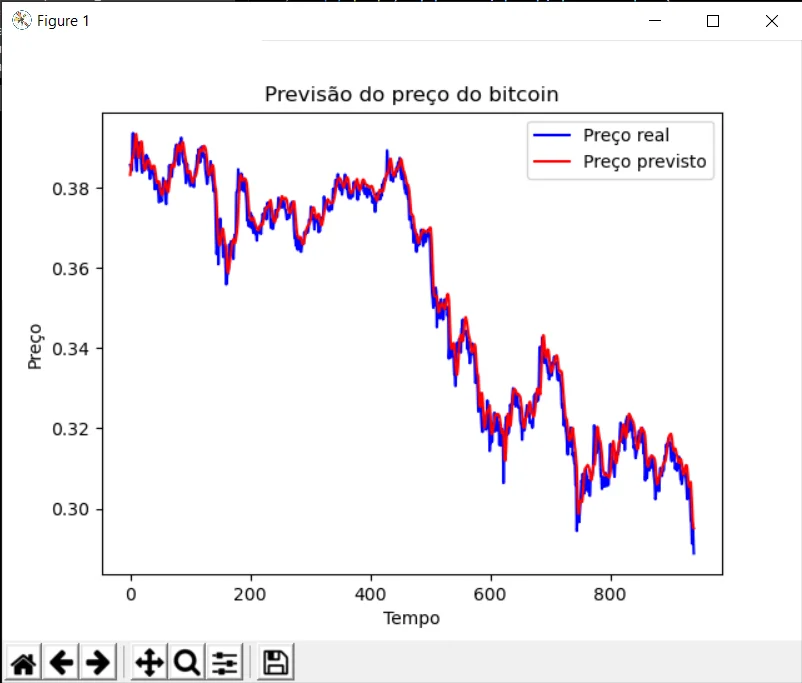
Apesar do bom resultado, é importante lembrar que tanto a previsão quanto os valores esperados estão normalizados, portanto, esse resultado não deve ser levado em consideração! Para uma comparação justa e sensata, é preciso transformar(desnormalizar) os valores de ambos vetores, farei isso ajustando o arquivo testa.py para que transforme os dados normalizados em valores reais através da função inverse_transform do SKLearn.
A função extrai_data(código abaixo) converte a coluna de data(string) em objetos(datetime) do python.
#prepara.py
from datetime import datetime

def extrai_data(caminho, nome_col):
    dados = pd.read_csv(caminho)
    col_pos = dados.columns.get_loc(nome_col)
    datas = dados.iloc[:, col_pos: col_pos + 1].values
    lista_data = []
    for i in range(0, len(datas)):
        data = datas[i, 0]
        partes = data.split('/')

        dia = partes[0]
        #ajusta os valores quando necessário(com 0 à esq.)
        if(len(dia) == 1):
            dia = '0' + dia
        mes = partes[1]
        if(len(mes) == 1):
            mes ='0' + mes

        data_completa = dia + '/' + mes + '/' + partes[2]
        #converte a string em objeto data
        data = datetime.strptime(data_completa, '%d/%m/%Y %H:%M:%S')
        lista_data.append(data)
    return lista_data
As alterações abaixo no arquivo testa.py transformam os dados normalizados em valores reais e exibem a data no eixo X do gráfico.
#testa.py
from prepara import carrega, prepara
from treina import cria_modelo
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.dates as dates
import joblib

def testa(modelo, caminho, hist, parametros, datas):
    if isinstance(modelo, str):
        temp = cria_modelo(hist, parametros)
        temp.load_weights(modelo)
        modelo = temp
    dados = carrega(caminho)
    dados_teste, dados_esperados = prepara(dados, 'Preço', hist)
    previstos = modelo.predict(dados_teste)
No código abaixo, armazenarei os valores reais na lista precos_reais e substituerei a coluna de preço com o valor previsto. Isso é necessário pois o normalizador salvo em disco não manipula matrizes de diferentes dimensões(logo, a matriz deve possuir o mesmo número de colunas da matriz utilizada no treinamento dos dados).
    col_preco = dados.columns.get_loc('Preço')
    dados = np.array(dados)
    precos_reais = []

    #armazena preço real e substitui no vetor pelo preço previsto
    for i in range(hist, len(dados)):
        precos_reais.append(dados[i,col_preco])
        dados[i, col_preco] = previstos[i - hist]
    #ignora as primeiras linhas que n possuem dados suficientes
    #para a previsão
    dados = dados[hist:len(dados), :]

    caminho = 'normalizador.joblib.pkl'
    normalizador = joblib.load(caminho)

    #transforma os valores normalizados em valores reais
    dados_transformados = normalizador.inverse_transform(dados)

    #seleciona todas as linhas da coluna do preço
    precos_previstos = dados_transformados[:, col_preco]
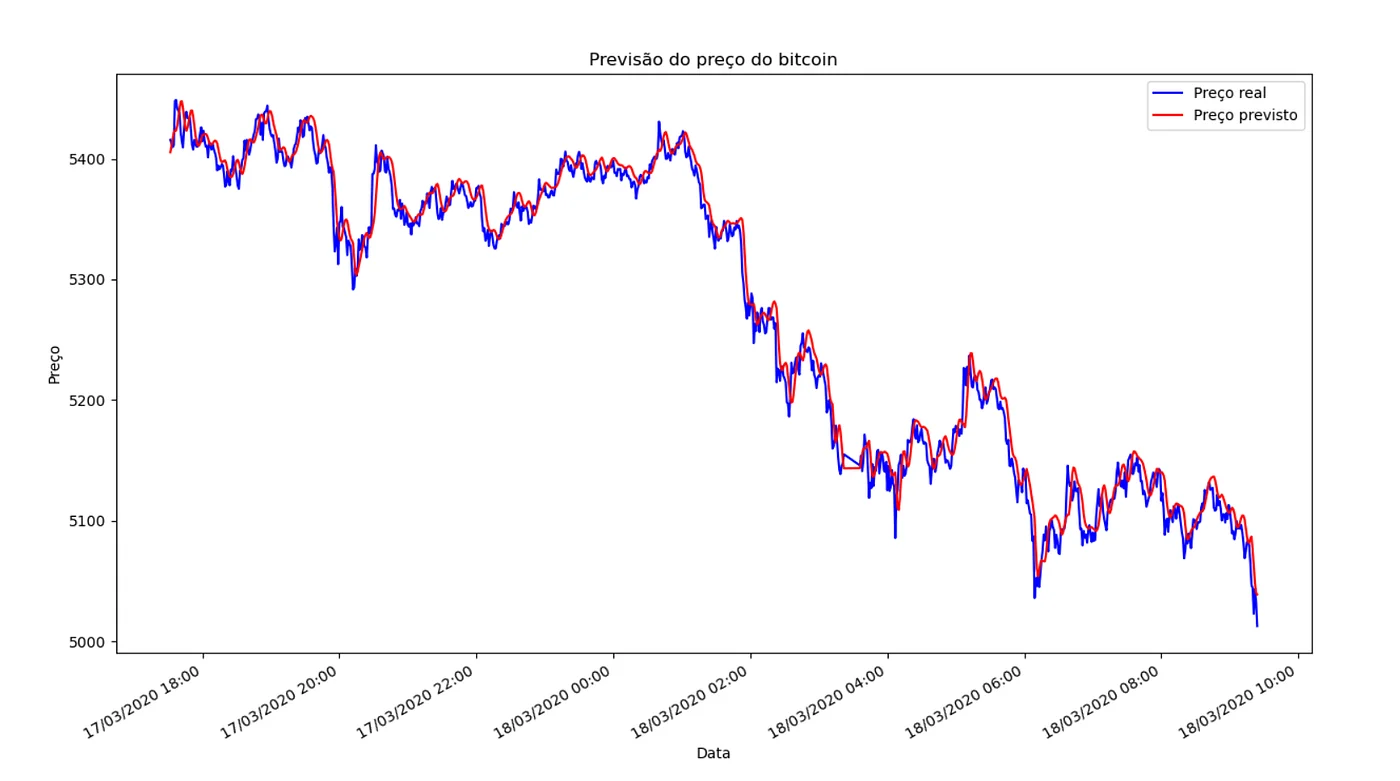
Com a lista de precos_previstos e a de precos_reais, é possível montar um gráfico para compará-las, utilizando a lista de datas no eixo X:
    fig, ax = plt.subplots()
    ax.plot(datas, precos_reais, color='blue', label='Preço real')
    ax.plot(datas, precos_previstos, color='red', label='Preço previsto')
    #formata data
    myFmt = dates.DateFormatter("%d/%m/%Y %H:%M")
    ax.xaxis.set_major_formatter(myFmt)
    plt.gcf().autofmt_xdate()
    plt.title('Previsão do preço do bitcoin')
    plt.xlabel('Data')
    plt.ylabel('Preço')
    plt.legend()
    plt.show()
Agora, no arquivo main.py, passarei a coluna de data como parâmetro.
#main.py
from prepara import carrega, extrai_data, prepara
from treina import cria_modelo, treina
from testa import testa

caminho = 'dados/btcusdt_teste.csv'
historico = 60
dados = carrega(caminho)
dados_treino = prepara(dados, 'Preço', historico)[0]
modelo = 'pesos.h5'
datas = extrai_data(caminho, 'Data')
datas = datas[historico: len(datas)]
testa(modelo, caminho, historico, dados_treino.shape[2], datas)
E esse é o resultado obtido:
Considerações Finais
O modelo proposto conseguiu acompanhar o preço com boa assertividade mas com um atraso de tempo em relação ao valor real. Acredito que possa ser utilizado para estudo e aprendizado do assunto, mas não recomendo aplicá-lo para transações do mundo real, visto que o preço do Bitcoin(ou de qualquer par/ativo/mercado) não depende unicamente de seus valores anteriores e é definido a partir de inúmeros fatores externos que não são facilmente calculados.
Publiquei o código completo com alguns ajustes no arquivo main.py(para facilitar o entendimento de cada fase) no github:
https://github.com/CAIOHOBORGHI/lstm_btcusdt
Deixo abaixo alguns links de artigos em inglês que me ajudaram neste desafio e ficarei contente em receber sugestões, dicas ou críticas construtivas sobre o que foi escrito.